

Når en side ikke dukker op i Google, er det fristende at tro, at der er én enkelt fejl, som forklarer det hele. Sådan ser virkeligheden sjældent ud. Google skelner tydeligt mellem crawling, indeksering og visning i søgeresultaterne, og en URL kan sagtens være kendt af Google uden at blive vist for brugerne.
Det gør fejlsøgning mere teknisk, men også mere håndgribelig. Når man arbejder systematisk med Google indeksering, er det ofte muligt at finde den konkrete årsag, eller flere årsager på én gang, og få siderne tilbage i spil.
Google indeksering: forskellen på crawling, indeksering og visning
Mange problemer starter med en forkert antagelse: at hvis Google har besøgt en side, så kommer den automatisk i søgeresultaterne. Det gør den ikke. Google beskriver selv processen som tre adskilte trin, hvor hver fase har sine egne krav og faldgruber.
En side kan altså være crawlet uden at blive indekseret. Og en side kan være indekseret uden at være synlig på de søgninger, man forventer.
[markdown] | Trin | Hvad Google gør | Hvad det betyder i praksis | | --- | --- | --- | | Crawling | Googlebot forsøger at hente URL'en | Siden er opdaget, men ikke nødvendigvis vurderet som værd at gemme | | Indeksering | Google analyserer indhold, signaler og kvalitet | Siden kan blive optaget i indekset, men det er ikke garanteret | | Visning i søgeresultater | Google vælger, om siden er relevant for en søgning | Selv indekserede sider kan være fraværende på vigtige søgeord | [/markdown]Det er netop derfor, at Google Search Console er så vigtig. Page Indexing report fortæller ikke bare, om en side er med eller ej. Den peger ofte direkte på, om problemet handler om blokering, duplikering, canonical URL, noindex, crawl errors eller noget helt femte.
10 årsager til at sider ikke vises i Google
Når sider mangler i søgeresultaterne, er det ofte en kombination af tekniske signaler og manglende kvalitetssignaler. Nedenfor er de ti mest almindelige årsager, med fokus på det, Google selv fremhæver i Search Central.
1. Siden er simpelthen for ny
Den mest jordnære forklaring er også en af de mest almindelige. Nye sider bliver ikke altid opdaget og vurderet med det samme. Hvis URL'en netop er publiceret, kan der gå tid, før Google crawler siden igen, analyserer indholdet og beslutter, om den skal indekseres.
Det gælder især sider på websites, der ikke publicerer ofte, eller hvor nye sider ikke bliver koblet tydeligt på via interne links. Et XML-sitemap kan hjælpe Google med at finde siden, men det er ikke en garanti for indeksering.
2. Siden har for få interne eller eksterne links
Google finder og prioriterer sider gennem links. Hvis en ny underside ligger dybt i strukturen, ikke er linket fra menuer, kategorier eller relaterede artikler, sender den svage signaler om betydning.
Det er et klassisk problem på større websites, hvor gode sider teknisk set findes, men praktisk set er usynlige. En URL uden intern linkkraft kan være kendt af Google, men stadig få lav crawlprioritet og begrænset sandsynlighed for indeksering.
3. robots.txt blokerer crawling
Hvis robots.txt forhindrer Googlebot i at hente siden, kan Google ikke læse indholdet normalt. Mange tror, at det automatisk betyder, at siden ikke kan indekseres. Det er ikke helt rigtigt. Google oplyser, at en blokeret URL stadig kan blive indekseret, hvis den er linket fra andre steder.
Det skaber tit forvirring, fordi man kan ende med en URL i søgeresultaterne uden fuldt indholdssnippet. Det er et tydeligt tegn på, at Google kender adressen, men ikke har fået adgang til selve siden.
En vigtig detalje er, at noindex ikke understøttes i robots.txt. Hvis målet er at forhindre indeksering, skal signalet ligge i HTML eller HTTP-headeren, ikke i robots-filen.
4. noindex fjerner siden fra Google
En noindex-regel er en direkte besked til Google om, at siden ikke skal optages i søgeindekset. Den kan sættes som meta-tag eller som HTTP-header, og begge metoder har samme effekt.
Her opstår der ofte fejl i forbindelse med staging-sites, filtrerede lister, gamle landingssider eller CMS-skabeloner, hvor noindex bliver kopieret videre til sider, som faktisk skulle være synlige.
I Search Console ses det ofte ret klart.
- Ekskluderet af noindex: Google har læst reglen og respekteret den
- Blokeret af robots.txt: Google kan muligvis slet ikke se, om der også er noindex
- Indsendt URL markeret som noindex: Siden ligger i sitemap, men beder samtidig om ikke at blive indekseret
Det sidste punkt er især værd at tage alvorligt, fordi det afslører modstridende signaler.
5. Canonical peger på en anden URL
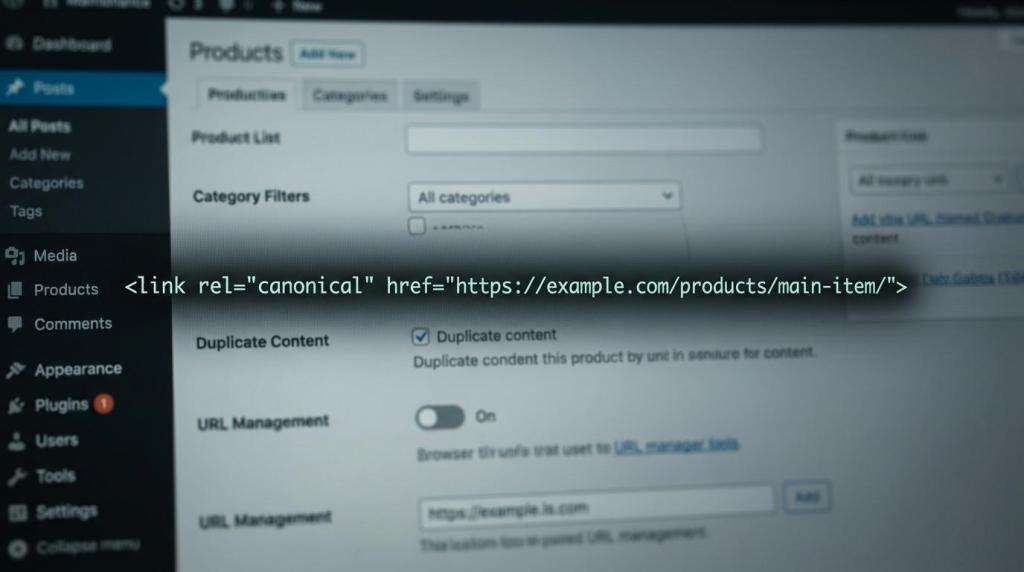
En canonical URL fortæller Google, hvilken version der skal opfattes som den primære. Det bruges ved duplicate content, sortering, filtre, URL-parametre, produktvarianter og andre næsten ens sider.
Hvis rel="canonical" peger på en anden side, kan Google vælge at ignorere den aktuelle URL i indekset. Det er ikke nødvendigvis en fejl. Det bliver først et problem, når canonical-signalet er sat forkert, eller når den peger på en side, der selv er svag, omdirigeret eller ikke-indekserbar.
Det ses tit efter redesigns, migreringer og automatiske CMS-regler.
6. Duplicate content gør Google i tvivl
Duplicate content handler ikke kun om kopieret tekst. Det kan også opstå, når samme indhold findes på flere adresser via HTTP og HTTPS, med og uden trailing slash, via printervenlige sider, sortering, pagination eller tracking-parametre.
Når flere URL'er ligner hinanden meget, vælger Google som regel én repræsentativ side og ignorerer resten. Det betyder, at den side, man gerne ville have vist, måske ikke bliver valgt.
Typiske kilder til duplicate content er ofte disse:
- filtrerede kategori-URL'er
- produktvarianter med næsten samme tekst
- HTTP/HTTPS-versioner
- www og non-www
- URL-parametre til tracking eller sortering
Her er samspillet mellem canonical, interne links, sitemap og 301 redirect afgørende. Hvis signalerne peger i forskellige retninger, bliver Googles valg mindre forudsigeligt.
7. Crawl errors stopper adgangen til indholdet
Hvis Googlebot møder tekniske fejl, falder sandsynligheden for både crawling og indeksering. Det kan være serverfejl, DNS-problemer, timeouts, adgangskrav, blokeringer via firewall eller ustabil hosting.
Nogle fejl er konstante. Andre opstår kun periodevis og er derfor sværere at fange. Det gør logfiler og serverovervågning vigtige på websites, hvor kritiske sider pludselig forsvinder ud af indekset.
En side, der ofte returnerer 5xx-fejl, sender ikke et tillidsvækkende signal til Google.
8. Siden ligner en soft 404
En soft 404 opstår, når serveren svarer med statuskode 200, men siden i praksis er tom, tynd, fejlpræget eller uden reelt indhold. Det kan være udsolgte produkter uden alternativer, søgesider uden resultater eller skabeloner med meget lidt unikt indhold.
Google vurderer i sådanne tilfælde, at siden ikke har nok værdi til at være i Search, selv om den teknisk set svarer korrekt.
Det er en vigtig påmindelse om, at korrekt statuskode ikke er nok. Siden skal også fremstå som en rigtig destinationsside med tydeligt formål og indhold.
9. Redirects og statuskoder er sat forkert
Forkerte redirects skaber ofte indekseringsproblemer, især efter migreringer. En 301 redirect er normalt det rigtige valg, når en side permanent er flyttet. Men hvis kæderne bliver lange, eller hvis URL'er skifter mellem redirects, 404 og 200 uden klar logik, bliver signalerne mudrede.
Der er også tilfælde, hvor sider returnerer 200, selv om de burde være 404 eller 410. Hvis en side er fjernet uden en relevant erstatning, anbefaler Google netop 404 eller 410. Det er et klart signal om, at siden ikke længere skal være indekseret.
Her opstår mange problemer i e-commerce, hvor udgåede produkter håndteres inkonsekvent.
10. Siden er indekseret, men ikke vist på de søgninger du forventer
Det sidste punkt bliver ofte overset. En side kan faktisk være indekseret og stadig opleves som “usynlig”, fordi den ikke rangerer på de søgninger, virksomheden holder øje med.
Google kan vælge ikke at vise siden bredt, hvis indholdet er svagt, ikke matcher søgeintentionen, er for tæt på andre sider på sitet, eller hvis robots meta rules begrænser visning af snippet eller andre elementer. Lav relevans er altså ikke det samme som teknisk fravær.
Det er her, mange fejlagtigt tror, at de har et indekseringsproblem, selv om de i virkeligheden har et indholds- eller intentproblem.
Sådan bruger du Search Console til at finde den rigtige fejl
Google Search Console er det naturlige startpunkt, men kun hvis rapporterne læses rigtigt. Kig først på den konkrete URL via URL-inspektion. Kig derefter på Page Indexing report for mønstre på tværs af website, kataloger og skabeloner.
Et enkelt URL-problem peger ofte på noindex, canonical eller intern linking. Et mønster på tværs af mange sider peger oftere på templates, robots-regler, redirects eller serveropsætning.
Det er især nyttigt at skelne mellem disse typer af signaler:
- Teknisk blokering: robots.txt, noindex, 401, 403, 5xx
- Indekseringsvalg: canonical URL, duplicate content, crawled currently not indexed
- Kvalitetsvurdering: soft 404, tyndt indhold, lav relevans
- Opdagelsesproblem: for få interne links, svagt sitemap, ny side
En praktisk prioritering af Google indeksering
Når flere fejl optræder samtidig, giver det mening at arbejde i en fast rækkefølge. Det sparer tid og minimerer risikoen for, at en rettelse skjuler en anden fejl.
- Tjek adgang: Kan Googlebot hente siden uden blokeringer eller serverfejl?
- Tjek indekseringssignaler: Findes der
noindex, forkert canonical eller modstrid mellem sitemap og meta-tags? - Tjek statuskode: Returnerer siden den korrekte HTTP-status?
- Tjek indholdet: Er siden unik, dækkende og tydeligt værdifuld?
- Tjek forbindelserne: Får siden interne links fra relevante og stærke sider?
Hvis en vigtig underside stadig ikke vises efter de kontroller, bør man se på logdata, rendering, JavaScript-afhængigheder og kvaliteten af de sider, der linker til den. Mange indekseringsproblemer virker i starten kryptiske, men bliver langt mere overskuelige, når de deles op i de tre grundlæggende spørgsmål: Kan Google hente siden? Vil Google indeksere siden? Vil Google vise siden?
Det er netop dér, arbejdet med Google indeksering bliver konkret, målbar og langt mere effektivt.